Réponse courte
Les codes HTTP 4xx signalent que la requête ne peut pas être satisfaite, et que la cause vient de la demande, pas du serveur. Leur nombre ne dit rien de la santé d’un site : c’est leur emplacement qui compte. Une erreur sur une URL que personne ne lie ne coûte rien, une erreur sur une page liée ou visitée est une fuite.
Le réflexe à corriger : compter ses 404. Le compteur du rapport d’indexation ne se vide jamais et ne veut rien dire tout seul. La question utile est de savoir d’où viennent les liens qui mènent à ces erreurs.
29 codes
la famille la plus fournie du registre. Une douzaine se rencontrent réellement sur un site, les autres sont applicatifs.
0 pénalité
un 404 ne fait pas baisser un site, Google l’écrit depuis 2011. Ce qui se perd, c’est ce qui pointait vers la page.
L’emplacement
la seule donnée qui compte. Une erreur atteinte depuis un lien interne, un lien externe ou un menu se paie ; les autres non.
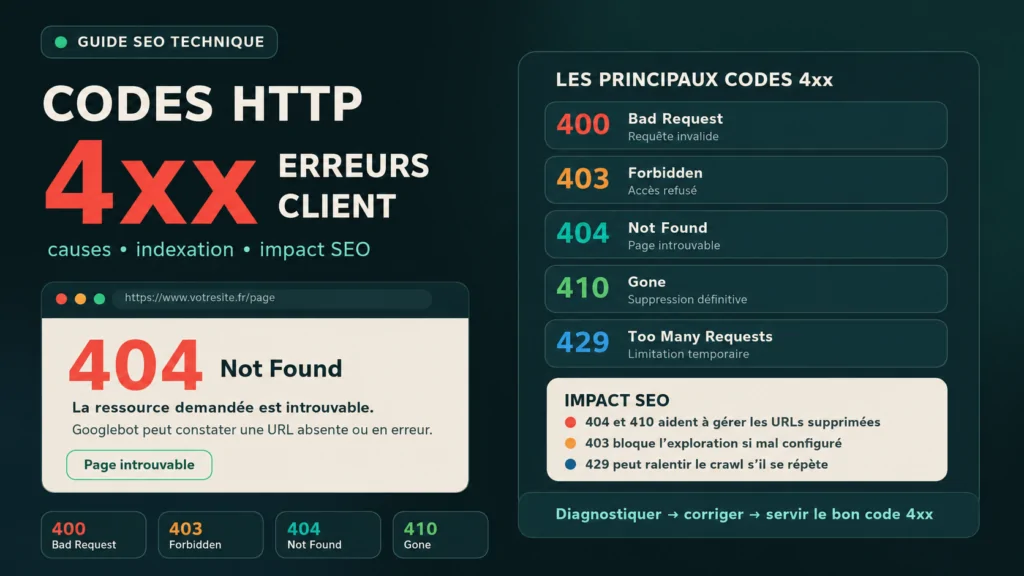
Les codes 4xx qu’un site rencontre vraiment
Douze codes sur les vingt-neuf du registre. Les dix-sept absents de ce tableau relèvent d’échanges applicatifs ou de protocoles qu’un site public ne sert jamais : ils sont tous documentés sur la page de référence des codes HTTP.
| Code | Ce qu’il signale | Enjeu SEO |
|---|---|---|
| 400 | La requête est mal formée et ne peut pas être lue | Aucune indexation possible |
| 401 | Une authentification est nécessaire pour accéder au contenu | Contenu invisible pour les robots |
| 403 | L’accès est refusé, et fournir une identité n’y changerait rien | Grave s’il ne vise que Googlebot |
| 404 | La ressource est introuvable, sans indication sur la suite | Sortie progressive de l’index |
| 405 | La ressource existe, mais pas avec cette méthode HTTP | Rare sur des pages, fréquent sur des API |
| 406 | Aucune version de la ressource ne convient à la demande | Souvent le fait d’un pare-feu applicatif |
| 408 | La requête a été abandonnée avant d’être complète | Symptôme de lenteur, à traiter comme tel |
| 410 | La ressource a été supprimée, et c’est définitif | Sortie de l’index plus rapide qu’un 404 |
| 413 | Le corps de la requête dépasse ce que le serveur accepte | Aucun, concerne les envois de fichiers |
| 414 | L’URL est trop longue pour être traitée | URL jamais indexée, souvent des paramètres |
| 429 | Trop de requêtes ont été envoyées en peu de temps | Fait chuter la cadence d’exploration |
| 451 | La ressource est retirée pour un motif juridique | Sortie de l’index sur la zone concernée |
Impact SEO des codes HTTP 4xx
Aucun de ces codes ne déclenche de sanction. Leur coût est indirect, et c’est ce qui les rend difficiles à faire prendre au sérieux.
À retenir
- 01Un 404 isolé ne coûte rien. C’est le fonctionnement normal du web, et Google le traite comme tel.
- 02Un 404 atteint depuis un lien perd tout ce que ce lien apportait : visiteurs, valeur transmise, chemin d’exploration.
- 03Un 403 servi à Googlebot seul est le plus coûteux de la famille : le site paraît en bonne santé et devient invisible.
Sur un site à fort volume d’URL, une masse de 4xx consomme du budget d’exploration sans rien rapporter. Le geste utile n’est pas de faire disparaître les erreurs, mais de corriger ce qui y mène.
Quand une erreur 4xx est normale
Vouloir un site sans aucune 4xx est une erreur de but. Quatre situations où le code est exactement la bonne réponse.
- Une page supprimée volontairement : un 404, ou un 410 si la suppression est assumée.
- Un espace privé ou sécurisé : un 401 quand une identification est attendue, un 403 quand l’accès est fermé quoi qu’il arrive.
- Une URL inventée : faute de frappe, lien tronqué dans un e-mail, adresse recopiée de travers. Le 404 est la seule réponse honnête.
- Une URL forgée par un robot : les tentatives d’accès à des chemins qui n’ont jamais existé. Elles gonflent le compteur sans rien signifier.
Ces erreurs-là n’appellent aucune action, sinon de ne pas les confondre avec les autres. C’est la raison pour laquelle un compteur global est inexploitable : il additionne des situations saines et des fuites réelles.
404, 410 ou 301 : que servir pour une page supprimée
C’est la décision qui revient dans chaque audit, et les trois réponses sont justes selon le cas.
301 s’il existe un équivalent
Une page qui répond à la même intention existe ailleurs. La redirection transmet la valeur acquise et le visiteur trouve ce qu’il cherchait. Attention à la destination : rediriger vers une page sans rapport revient à ne rien rediriger du tout.
410 si la suppression est assumée
Le contenu a disparu et rien ne le remplace. Le 410 le dit sans ambiguïté et fait sortir l’URL de l’index plus vite qu’un 404. À réserver aux suppressions décidées, pas aux disparitions accidentelles.
404 dans le doute
La page n’existe pas, et vous ne savez pas si c’est définitif. Le 404 laisse la porte ouverte à une remise en ligne, au prix d’une sortie de l’index plus lente. C’est le repli sûr, jamais une faute.
Sur votre site
Vos erreurs 4xx sont-elles au bon endroit ?
Je sépare les erreurs saines des fuites réelles : celles qui reçoivent des liens externes, celles qui sont encore liées depuis vos pages, et celles qui n’appellent aucune action. Réponse sous 24 heures ouvrées.
Bonnes pratiques de gestion des erreurs 4xx
Quatre gestes, dans l’ordre où ils rapportent.
- 01Corriger le maillage interne cassé d’abord. Un lien interne vers une page morte est le seul cas où vous êtes à la fois la cause et la victime. Voir la fiche maillage interne.
- 02Traiter ensuite les erreurs qui reçoivent des liens externes. Ce sont des recommandations acquises qui se perdent dans le vide. Une redirection vers l’équivalent le plus proche les récupère.
- 03Ne pas rediriger le reste vers l’accueil. Google traite une redirection vers une page sans rapport comme une page introuvable, avec une règle de plus à maintenir.
- 04Surveiller par les journaux serveur, pas seulement par la Search Console. Les journaux montrent quelles URL en erreur Googlebot demande encore, et à quelle fréquence. C’est là que se mesure ce que ces erreurs coûtent réellement.
Le cas à ne pas manquer. Un 403 servi uniquement à Googlebot, par une règle de sécurité ou un pare-feu applicatif trop zélé. Le site fonctionne parfaitement dans un navigateur, et les pages sortent de l’index sans que rien ne l’annonce. Le seul moyen de le voir est de tester une URL en se déclarant comme Googlebot, ou de lire les journaux serveur.
Les codes 4xx qui ont leur fiche
400Bad Request
La requête est mal formée. Souvent un paramètre, un en-tête ou un caractère qui n’a rien à faire là.
Lire la fiche →
401Unauthorized
Une identification est attendue. Fréquent sur les préproductions laissées ouvertes aux robots.
Lire la fiche →
403Forbidden
L’accès est fermé. Le plus coûteux de la famille quand il ne frappe que Googlebot.
Lire la fiche →
404Not Found
La ressource est introuvable. Normal en soi, coûteux selon l’endroit où il tombe.
Lire la fiche →
405Method Not Allowed
La ressource existe, mais pas avec cette méthode. Un sujet d’API plus que de pages.
Lire la fiche →
410Gone
La suppression est assumée. Sort de l’index plus vite qu’un 404, à réserver aux décisions.
Lire la fiche →
429Too Many Requests
La limite de débit est atteinte. Le seul 4xx dont l’effet ressemble à celui d’une panne serveur.
Lire la fiche →
Les autres familles de codes
1xxRéponses informatives
Des étapes intermédiaires, jamais un résultat. Sans effet sur l’indexation, sauf le 103 Early Hints.
Lire la fiche →
2xxRequêtes réussies
La famille qu’on croit acquise. Un seul de ses codes rend une page indexable, sans le mériter.
Lire la fiche →
3xxRedirections
La seule famille que vous écrivez vous-même. Un 3xx n’arrive pas, il se décide.
Lire la fiche →
5xxErreurs serveur
La famille la plus critique : répétée, elle fait reculer l’exploration sur tout le domaine.
Lire la fiche →
Questions fréquentes sur les codes 4xx
Les erreurs 404 pénalisent-elles le référencement ?
Non. Google l’écrit explicitement : un 404 ne fait pas baisser un site, c’est le fonctionnement normal du web. Ce qui se perd est ailleurs : les visiteurs qui arrivaient sur la page, les liens externes qui pointaient vers elle, et la position qu’elle occupait. La perte est réelle, la sanction n’existe pas.
Combien de 404 sont acceptables sur un site ?
La question n’a pas de réponse chiffrée, parce que le nombre n’est pas la bonne mesure. Un site peut afficher des milliers de 404 sur des URL forgées par des robots sans que cela ait la moindre conséquence, et en souffrir avec dix erreurs bien placées. Triez par origine du lien, pas par volume.
Faut-il rediriger toutes les pages en 404 ?
Non. Redirigez celles qui reçoivent des liens ou du trafic, et seulement s’il existe une page équivalente. Pour le reste, le 404 est la bonne réponse. Une redirection vers une page sans rapport est traitée par Google comme une page introuvable, avec une règle de plus à maintenir.
Quelle différence entre un 401 et un 403 ?
Le 401 dit « identifiez-vous » : l’accès est possible pour qui présente les bons identifiants. Le 403 dit « c’est fermé » : s’identifier n’y changerait rien. Pour un moteur, les deux rendent la page inaccessible, mais un 403 inattendu est le signal d’une règle de sécurité mal calibrée.
Pourquoi une page s’affiche-t-elle alors que Google la voit en 403 ?
Parce que la restriction ne vise pas les visiteurs mais les robots. Un pare-feu applicatif, une protection anti-scraping ou une règle de blocage par adresse peuvent refuser Googlebot tout en laissant passer les navigateurs. Le site paraît sain et sort de l’index. Testez une URL en vous déclarant comme Googlebot, ou lisez les journaux serveur.
Sources
- 1RFC 9110 : les réponses d’erreur client 4xx
- 2MDN : le statut 404 Not Found
- 3Google Search Central : les erreurs 404 nuisent-elles à un site
- 4Google Search Central : comment Google traite les codes HTTP et les erreurs réseau
- 5Les fiches Budget de crawl et Maillage interne du lexique
Articles similaires


Powered by : Damien Hernandez
